n°1
 Scanner
SELECT * FROM table;
Lire toutes les colonnes d'une table. * veut dire « toutes les colonnes ».
n°2
Sélecteur
SELECT col1, col2 FROM table;
Ne liste que les colonnes utiles, séparées par des virgules.
n°3
Filtre
SELECT * FROM t WHERE col = 'text';
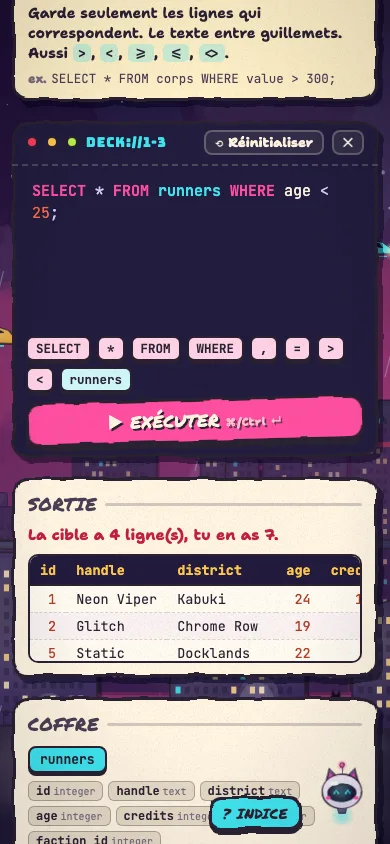
Garde seulement les lignes qui correspondent. Le texte entre guillemets. Aussi >, <, >=, <=, <>.
n°4
Double Verrou
WHERE a AND b / WHERE a OR b
AND : les deux vrais. OR : au moins un.
n°5
Trieur
ORDER BY col DESC LIMIT n
ORDER BY trie (ASC = petit d'abord, DESC = grand d'abord). LIMIT garde les n premières lignes.
n°6
Dédoublonneur
SELECT DISTINCT col FROM t;
Supprime les lignes en double du résultat.
n°7
Lance-filet
col IN ('a','b') col BETWEEN x AND y
IN : une valeur de la liste. BETWEEN : un intervalle, bornes incluses.
n°8
Joker
col LIKE 'Ne%'
% = n'importe quels caractères, _ = exactement un.
n°9
Détecteur de fantômes
col IS NULL col IS NOT NULL
NULL = « pas de valeur ». Jamais = NULL : utilise IS NULL.
n°10
Étiqueteuse
SELECT price * 2 AS double_price FROM t;
Calcule avec + - * / et nomme la colonne avec AS.
n°11
Compteur
SELECT COUNT(*) FROM t;
COUNT(*) compte les lignes. COUNT(col) ignore les NULL.
n°12
Calculateur
SUM(col) AVG(col) MIN(col) MAX(col)
Écrase plusieurs lignes en un seul nombre.
n°13
Choixpeau
SELECT col, COUNT(*) FROM t GROUP BY col;
Une ligne par groupe. Les agrégats sont calculés dans chaque groupe.
n°14
Porte des groupes
GROUP BY col HAVING COUNT(*) > 2
WHERE filtre les lignes avant, HAVING filtre les groupes après.
n°15
Classement
ROUND(AVG(col)) ... ORDER BY SUM(col) DESC
Les agrégats peuvent être arrondis et triés comme une colonne.
n°16
Connecteur
FROM a JOIN b ON a.b_id = b.id
Colle les lignes de deux tables quand la clé correspond.
n°17
Surnoms
FROM runners r JOIN factions f ON ... WHERE f.name = ...
Donne des alias courts aux tables (r, f) et filtre après la jointure.
n°18
Filet
FROM a LEFT JOIN b ON ...
Garde toutes les lignes de gauche, avec des NULL si rien ne correspond.
n°19
Chaîne
FROM a JOIN b ON ... JOIN c ON ...
Enchaîne les jointures pour traverser une table de liaison.
n°20
Pointeur
FROM a JOIN b ON ... GROUP BY a.name
Joins d'abord, puis groupe pour compter ou sommer.
n°21
Miroir
FROM t a JOIN t b ON a.parent_id = b.id
Joins une table avec elle-même grâce à deux alias.
n°22
Requête gigogne
WHERE col > (SELECT AVG(col) FROM t)
Une requête entre parenthèses donne une valeur à comparer.
n°23
Portail
WHERE id IN (SELECT ... ) NOT IN (...)
Compare avec une liste produite par une autre requête. Attention : NOT IN avec un NULL dans la liste ne renvoie rien.
n°24
Aiguillage
CASE WHEN cond THEN 'a' ELSE 'b' END AS label
Choisit une valeur ligne par ligne. Le premier WHEN vrai gagne.
n°25
Fusion de flux
SELECT a FROM t1 UNION SELECT b FROM t2
Empile deux résultats de même nombre de colonnes. UNION enlève les doublons, UNION ALL les garde.
n°26
Mémoire nommée
WITH name AS (SELECT ...) SELECT ... FROM name
Nomme d'abord un sous-résultat, puis interroge-le comme une table.
n°27
Outils texte
UPPER(x) LOWER(x) LENGTH(x) a || ' ' || b
Transforme le texte. || colle des chaînes.
n°28
Injecteur
INSERT INTO t (a, b) VALUES (1, 'x');
Ajoute une ligne. Les valeurs suivent l'ordre des colonnes.
n°29
Réécriveur
UPDATE t SET col = value WHERE ...;
Modifie des lignes. Sans WHERE, TOUTES les lignes changent !
n°30
Gomme
DELETE FROM t WHERE ...;
Supprime des lignes. Sans WHERE, la table est vidée !
n°31
Bâtisseur
CREATE TABLE t (id INTEGER PRIMARY KEY, name TEXT);
Crée une table : chaque colonne a un nom et un type.
n°32
Classeur
RANK() OVER (PARTITION BY g ORDER BY x DESC)
Les fonctions de fenêtre calculent sur des lignes liées sans les fusionner. PARTITION BY recommence par groupe.
n°33
Cumul
SUM(x) OVER (ORDER BY id) AVG(x) OVER (PARTITION BY g)
Un agrégat avec OVER garde chaque ligne : cumuls, moyennes de groupe…
 République en Kit
 Agora
 Hangeul Express
 Mémoire Vive
 Intox
 Zéro Faille
 Maison Flex
 Biais & Bâtons
 Git Quest
 RGPD.exe
 Premier Réflexe
 Hameçon
 Kana Shinkansen
 Rideau de Fer
 Coup de Pinceau
 Cellule 404
 Bon à tirer
 Bas de Laine
 Consignation
 Fourche Levée
 Marche en Avant
 Dos Droit
 Point de Rassemblement
 Mise au point
 Électron Libre